Dive into Claude Code
- 作者:Jiacheng Liu、Xiaohan Zhao、Xinyi Shang、Zhiqiang Shen
- 原文:本地 PDF · arXiv v2
- 项目:VILA-Lab/Dive-into-Claude-Code
- 状态:阅读中
2 Design Philosophies, Design Principles and Architectural Motivations(设计理念、设计原则与架构动机)
章节导言
原文要点
生产级 Agent 的核心张力是:自主执行使它产生价值,但人类仍应控制目标的实现方式。Anthropic 的安全框架提出这组约束 [2];Claude’s Constitution 则倾向用可结合情境的判断与价值观处理它,而不是写死每一种决策流程 [3]。论文再结合开发者实际使用 Claude Code 的研究 [4]、[5],归纳出塑造架构的五类人本价值 [1]。
读者理解
这段主要讨论 Claude Agent 如何划定自动执行与人类介入的边界。这条边界不应只由固定规则预先决定;为了知道何时可以放手、何时必须介入,产品设计还应参考真实用户的长期使用轨迹。
原文边界与待验证
“把所有用户的使用轨迹作为输入”是进一步推论,不是论文所说的运行时输入。更准确地说,论文把聚合后的使用研究作为架构设计的证据。McCain 等人的数据表明,完整自动批准率会从不足 50 次会话用户的约 20%,逐步升至 750 次会话用户的 40% 以上;与此同时,有经验的用户也会更频繁地中断 Agent,说明监督方式会随信任积累而变化 [5]。系统最终应使用个人轨迹还是群体数据,以及如何处理隐私和授权,仍需继续验证。
2.1 Five Values and Philosophies(五类价值与理念)
Human Decision Authority(人类决策权)
人类保留最终决策权;Agent 可以在明确边界内自主工作,但人必须能够观察、批准、拒绝、中断和事后审计它的行为 [1]。
Safety, Security, and Privacy(安全、安全防护与隐私)
决策权强调人有权选择,安全则强调即使人疏忽或判断失误,系统仍有义务保护代码、数据与基础设施,并防范越权、注入和隐私泄露 [1]、[2]。
Reliable Execution(可靠执行)
可靠不只是单次回答正确,而是始终忠实于人的真实意图,在长任务、上下文切换和任务委派中保持连贯,并在宣布完成前验证结果 [1]。
Capability Amplification(能力放大)
我的理解是:Claude 的能力放大不依赖显式状态图或决策执行器来规定下一步,而是让模型负责决策,再由上下文管理、工具路由和失败恢复等确定性基础设施支撑执行。它们不是另一套决策逻辑,而是让更强模型的能力可以直接转化为更强工作流,无需同步重写编排框架 [1]、[4]。
Contextual Adaptability(情境适应性)
我的理解是:Claude 的自主性由模型、用户和产品共同建构。系统面向的是随使用经验不断变化的信任轨迹,而不是固定信任状态;用户行为会改变授权和监督方式,但这不等于模型会单方面自动更新一个内部“用户信任值” [1]、[5]。
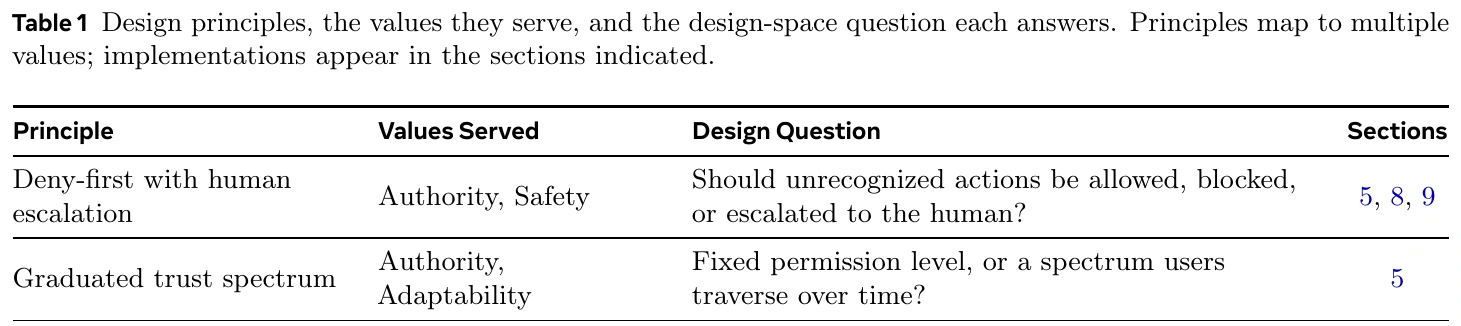
表 1 节选:与自动执行边界最相关的两项原则——未知动作先拒绝并升级给人,以及用户随时间进入更高信任级别 [1]。
2.2 Design Principles(设计原则)
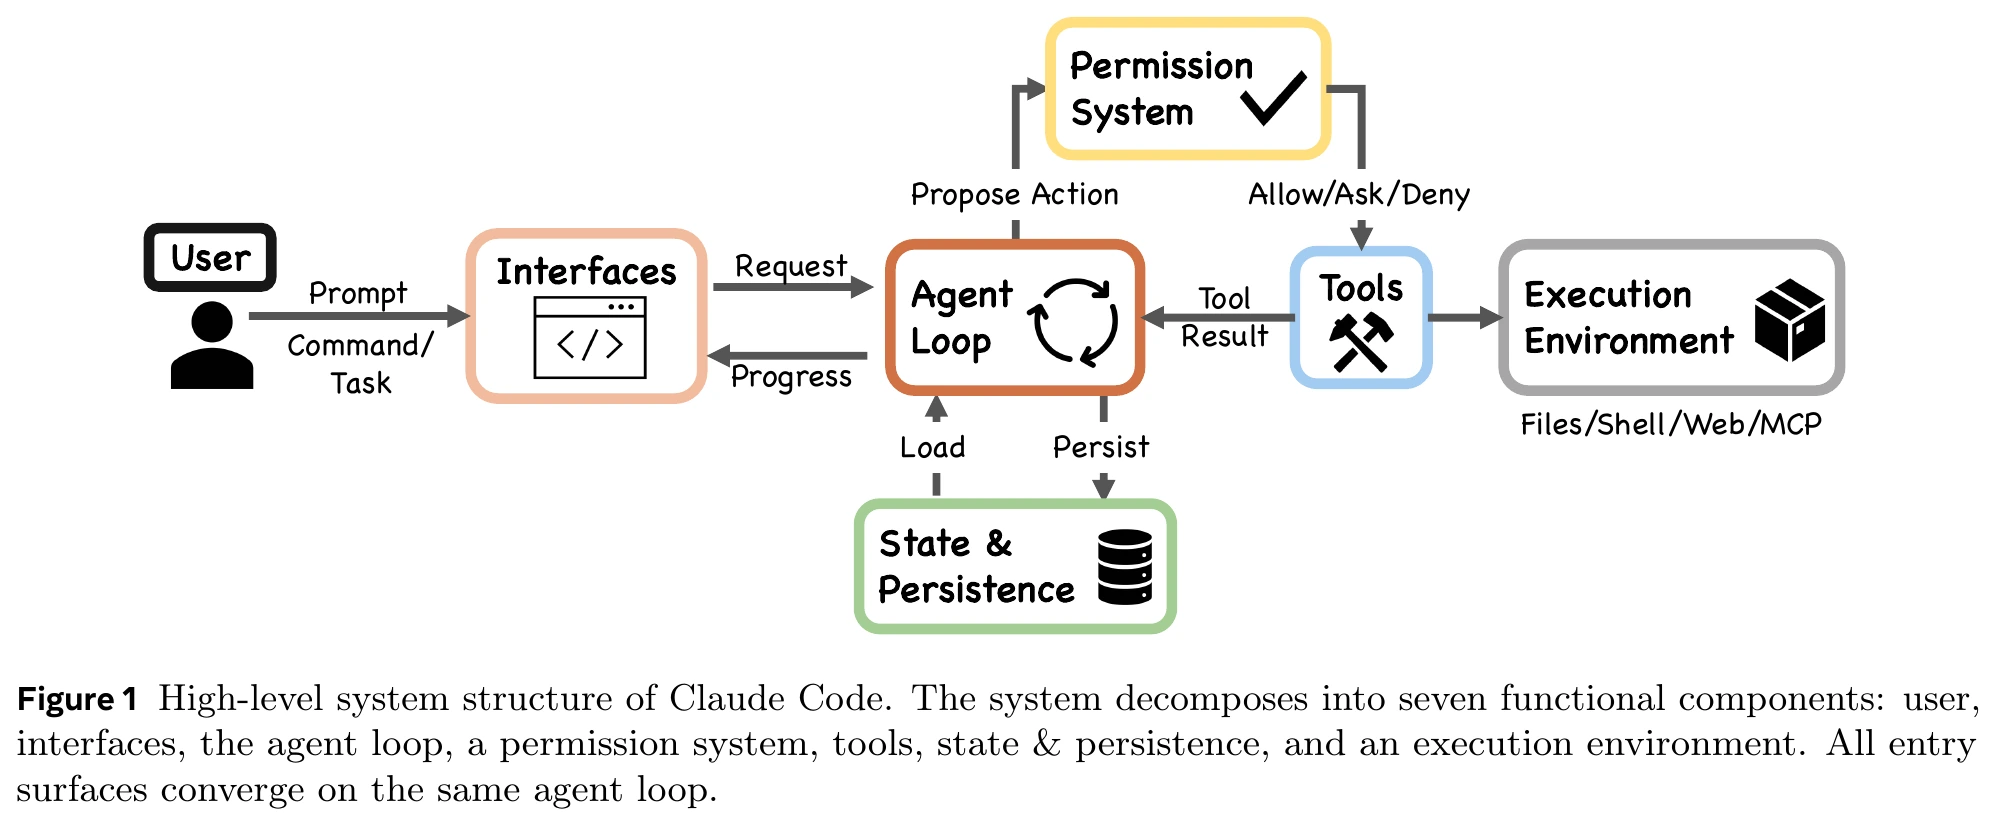
图 1:Claude Code 的高层系统结构。系统由用户、界面、Agent Loop、权限系统、工具、状态与持久化、执行环境七个功能组件组成;所有入口最终汇入同一个 Agent Loop,截自原论文 [1]。
3 Architecture Overview(架构概览)
3.1 Design Questions and Running Example(设计问题与贯穿示例)
本节用四个问题概括 Claude Code 的架构选择 [1]:
- 推理放在哪里? 模型负责决定做什么,Harness 负责把结构化的
tool_use请求经过权限校验后执行并回收结果,使推理与执行、安全约束相互分离。 - 需要多少个执行引擎? 交互式终端、Headless CLI、Agent SDK 和 IDE 集成共用同一个
queryLoop(),只有渲染与用户交互层随入口变化。 - 默认安全姿态是什么? 采用“拒绝优先、人工升级”(deny > ask > allow),并让权限规则、
PreToolUseHook,以及启用时的 Auto-mode 分类器和可选 Shell 沙箱组成彼此独立、任一层都可阻断的多层防线。 - 绑定资源约束是什么? 上下文窗口是核心瓶颈,因此采用按成本由低到高运行的五层上下文削减与压缩流水线,分别处理不同类型的上下文压力。
3.2 High-Level System Structure(高层系统结构)
Claude Code 的高层结构由七个功能组件构成 [1]:
- User(用户):提交提示、审批权限并检查输出。
- Interfaces(界面):交互式 CLI、Headless CLI(
claude -p)、Agent SDK 和 IDE/桌面/浏览器入口最终都汇入同一个 Agent Loop。 - Agent Loop(代理循环):由
queryLoop()异步生成器反复执行模型调用、工具分发与结果收集。 - Permission System(权限系统):组合拒绝优先的规则评估、Auto-mode 分类器和 Hook 拦截。
- Tools(工具):
assembleToolPool()汇合内置工具与 MCP 工具,插件则通过 MCP 服务和 Skill/Command 注册表间接扩展能力。 - State & Persistence(状态与持久化):以追加式 JSONL 会话记录、全局提示历史和子代理 Sidechain 文件保存状态,并支持恢复、分叉与回退。
- Execution Environment(执行环境):承载可选沙箱中的 Shell 执行、文件系统操作、网页访问、MCP 连接和远程执行。
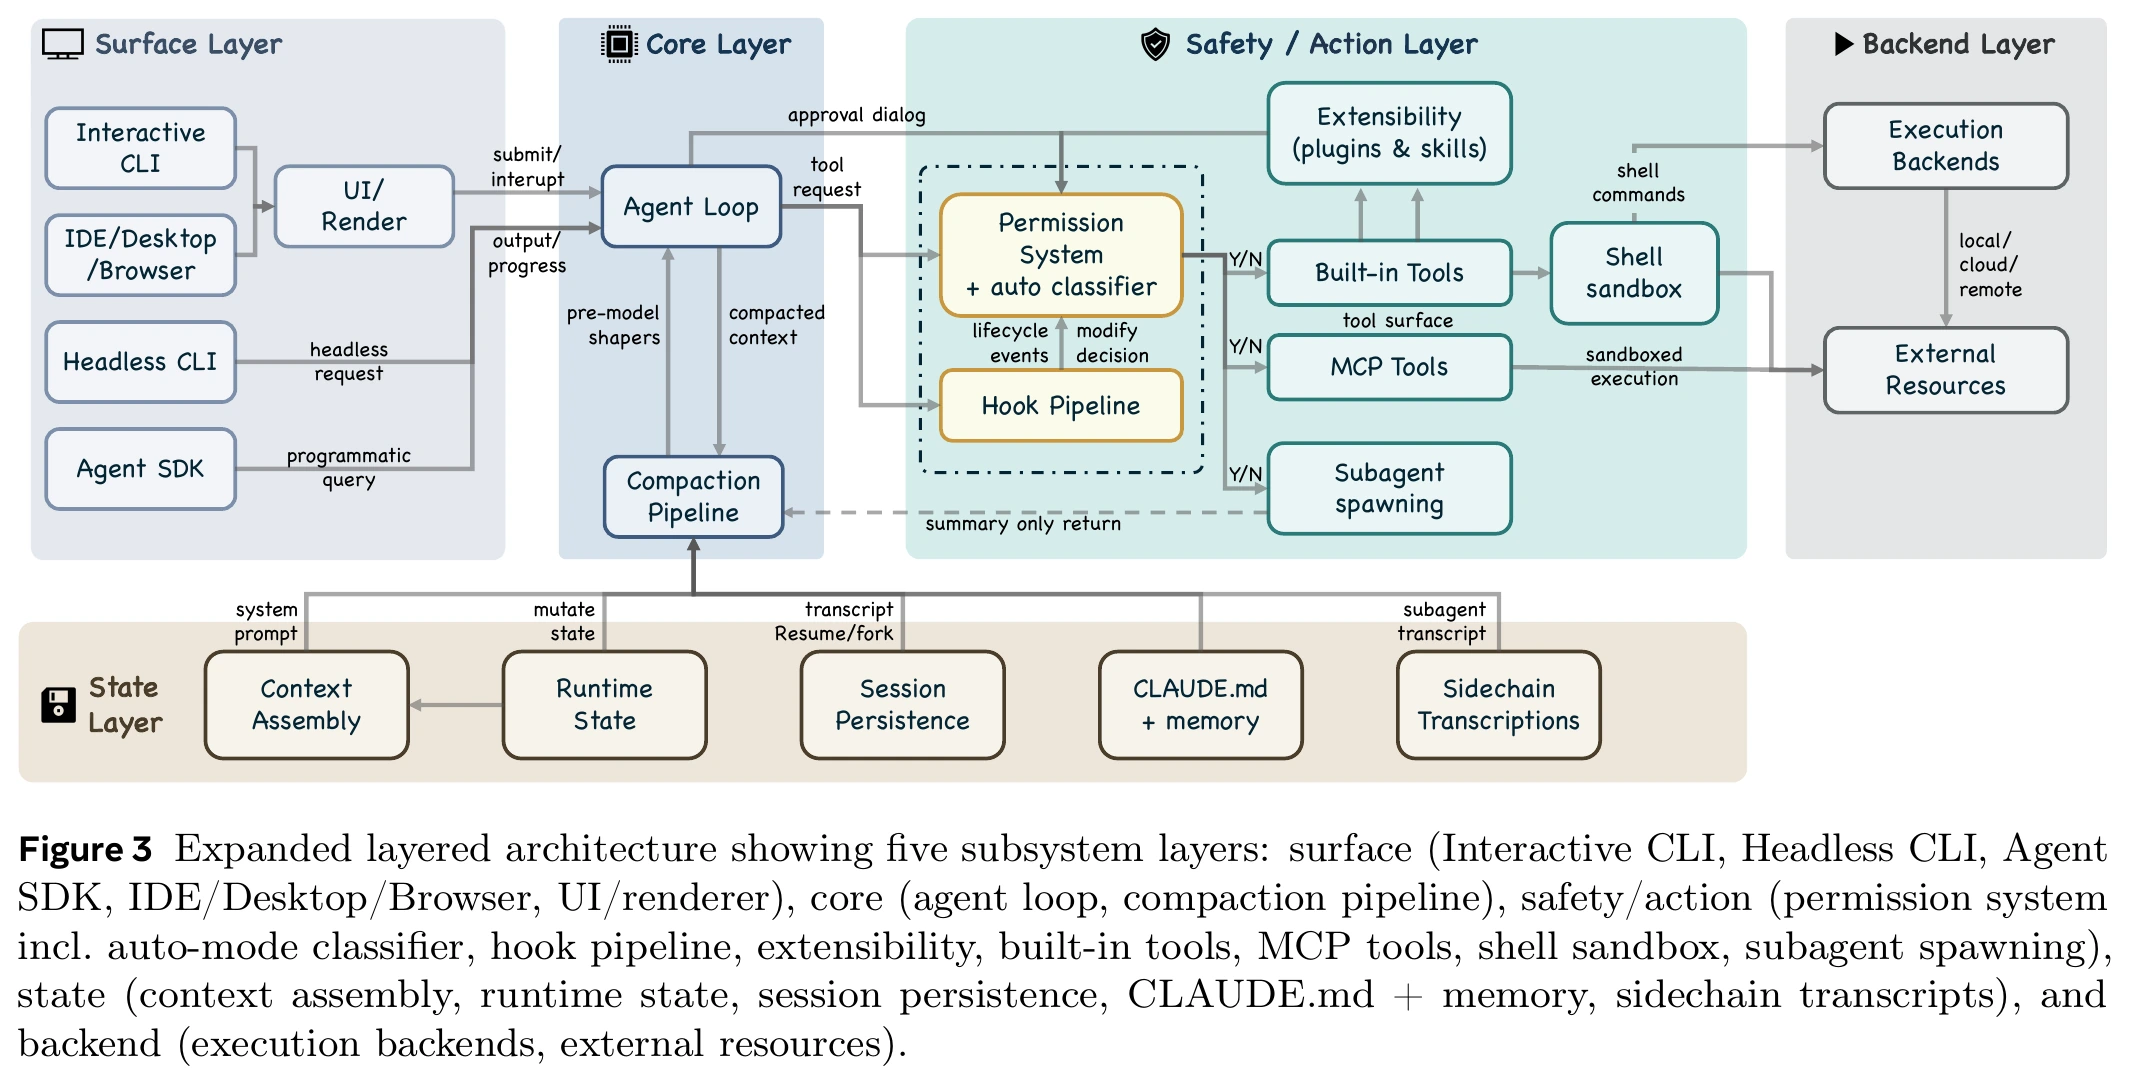
图 3:Claude Code 的扩展分层架构。七组件模型进一步展开为 Surface、Core、Safety / Action、State 和 Backend 五个子系统层,截自原论文 [1]。
4 Turn Execution: The Agentic Query Loop(单轮执行:Agent 查询循环)
4.1 The Query Pipeline(查询流水线)
每一轮都由 queryLoop() 按固定顺序推进 [1]:
- 解析与初始化:解析系统提示、用户上下文、权限回调和模型配置,并用一个
State对象集中保存消息、工具上下文、压缩状态与恢复计数器。 - 组装上下文:从最近一次压缩边界之后取回消息,再依次运行五个模型调用前的上下文整形器。
- 流式调用模型:将组装后的消息、完整系统提示、工具集、模型配置和中止信号交给模型,并持续接收输出。
- 执行并回灌:若模型返回
tool_use,请求依次经过工具分发和权限校验;执行结果以tool_result加回对话,进入下一轮迭代。 - 结束本轮:若模型只返回文本、不再请求工具,本轮执行结束。
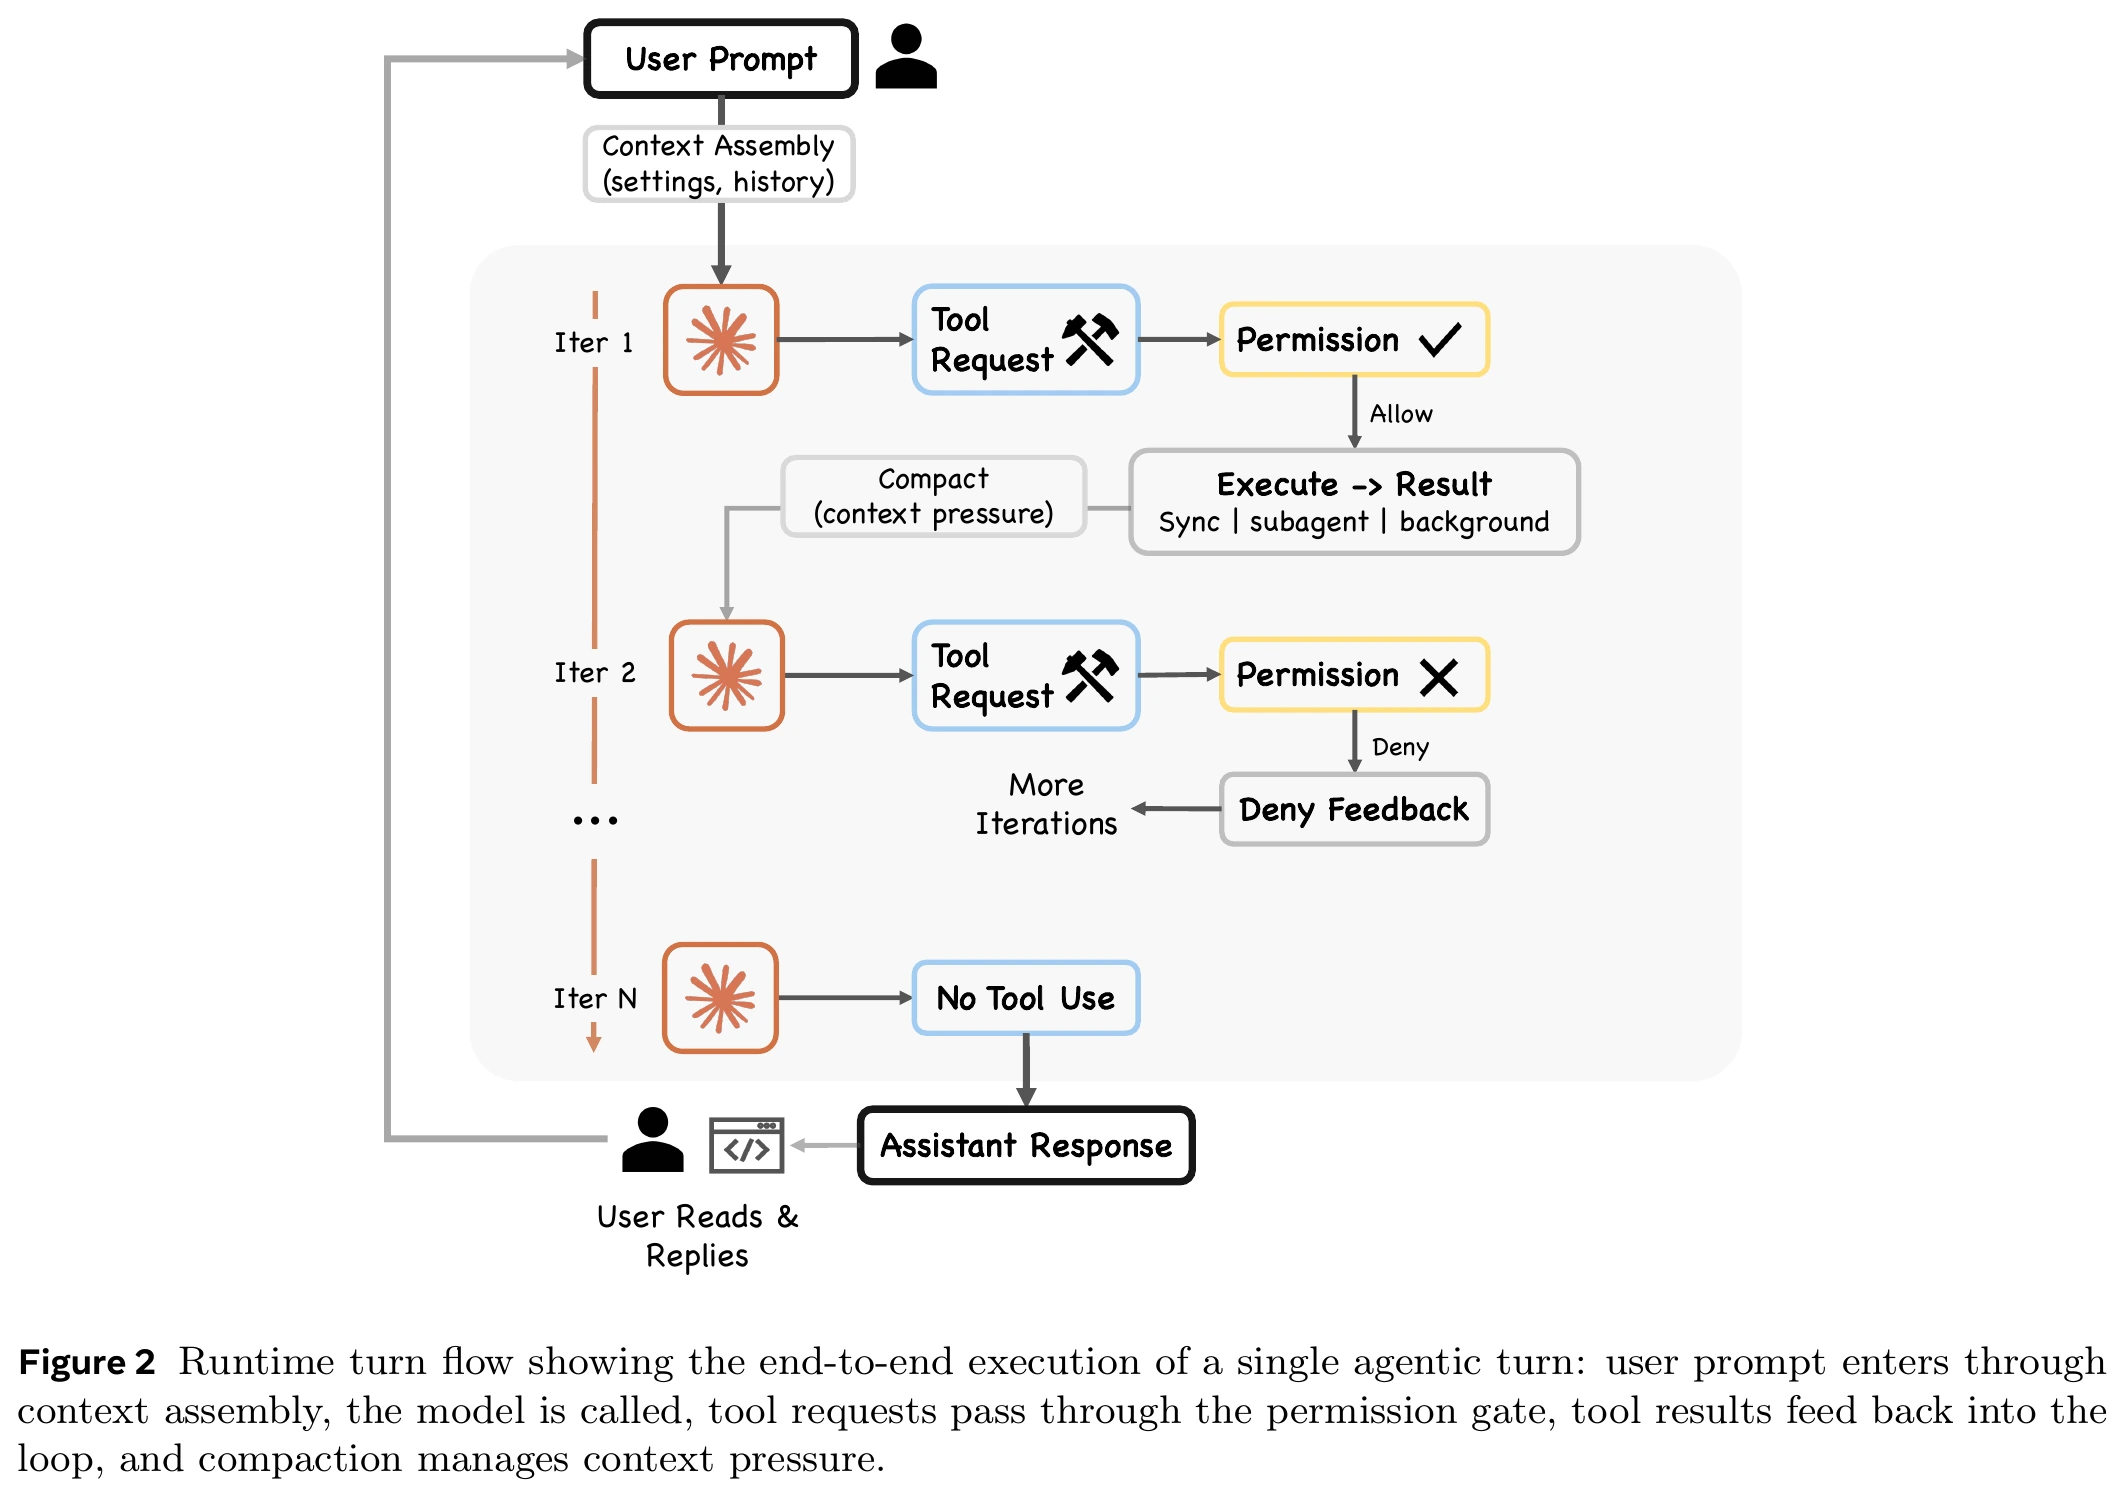
图 2:Claude Code 单轮运行流程。用户提示经过上下文组装后进入模型,工具请求通过权限门,执行结果回流到下一次迭代;上下文压力升高时触发压缩,截自原论文 [1]。
论文将这个循环归入 ReAct 模式:模型生成推理和工具调用,Harness 执行动作,结果再进入下一轮。queryLoop() 以 AsyncGenerator 向界面持续产出事件,同时在循环内部保持单一顺序控制流;这种设计以较低延迟和实现简单性为优先,代价是每轮沿一条动作轨迹前进,不做树搜索式回溯 [1]。
4.2 Tool Dispatch and Streaming Execution(工具分发与流式执行)
模型响应中出现 tool_use 后,系统提供两条执行路径 [1]:
- 流式主路径:
StreamingToolExecutor在工具调用仍随模型响应流式到达时就开始执行,以降低一次响应包含多个工具时的等待时间。 - 批处理后备路径:
runTools()先由partitionToolCalls()将调用划分为可并发组,再逐组执行。 - 安全并发原则:两条路径都会区分可安全并发与必须独占的工具;只读操作可以并行,Shell 等修改状态的操作保持串行。
流式执行器用 Sibling Abort Controller 在任一 Bash 工具报错时终止其他在途子进程,并用进度信号唤醒结果消费者。即使工具并行运行,结果也会先缓冲,再严格按照工具请求的原始顺序输出;两条路径最终都暴露为同一种异步结果流,供同一个 for await 循环消费。若 PostToolUse Hook 发出停止信号,循环也会阻止继续执行 [1]。
4.3 Pre-Model Context Shapers(模型调用前的上下文整形器)
每次模型调用前,query.ts 都会依次处理 messagesForQuery。它不是单一的“摘要器”,而是按成本由低到高缓解不同类型上下文压力的五层流水线 [1]:
- Budget reduction(工具结果预算裁剪):限制单条工具结果的大小,将超长输出替换为可恢复的内容引用;直接防止一次命令输出或文件读取撑满上下文窗口。
- Snip(旧历史轻量裁剪):在
HISTORY_SNIP启用时移除较早的历史片段,并记录释放的 token 数和裁剪边界,优先缓解长会话的历史膨胀。 - Microcompact(细粒度压缩):始终运行基于时间的压缩路径;启用
CACHED_MICROCOMPACT后,还会依据 API 返回的真实缓存删除 token 数处理边界消息。 - Context collapse(上下文折叠):在
CONTEXT_COLLAPSE启用时,为模型临时构建折叠后的历史视图;它不改写 REPL 保存的完整历史,因此仍可恢复和重建。 - Auto-compact(自动完整压缩):仅当前四层仍无法把上下文降到压力阈值以下时,才调用模型生成语义摘要,并将摘要组织为后续调用的上下文。
这是一种“先轻量、可逆、低损失,再做昂贵语义压缩”的渐进式退化设计:前四层尽可能避免额外模型调用,最后一层才以完整摘要换取更多可用窗口 [1]。
4.5 Stop Conditions(停止条件)
queryLoop() 并不只在 Agent 成功给出答案时结束。论文列出五种会终止循环的条件 [1]:
- No tool use(无工具调用):模型只产生文本、不包含
tool_use;这是正常完成的主路径。 - Max turns(最大轮数):达到可配置的
maxTurns上限。 - Context overflow(上下文溢出):API 返回
prompt_too_long;系统会先尝试相关恢复机制,无法恢复才终止。 - Hook intervention(Hook 介入):
PostToolUseHook 设置hook_stopped_continuation,阻止本轮继续执行。 - Explicit abort(显式取消):
abortController收到取消信号。
前两项分别覆盖正常完成和预算上限,后三项覆盖资源、策略与用户控制权带来的终止;它们共同避免 Agent 在无明确退出路径时无限循环 [1]。
6 Extensibility: MCP, Plugins, Skills, and Hooks(可扩展性:MCP、插件、技能与 Hook)
章节导言
图 5 将一个 Agent Loop 细化为三个扩展插入点 [1]:assemble() 决定模型看见什么(系统提示、历史、Skill 描述与 Hook 注入的上下文);model() 在统一工具池中决定模型能调用什么;execute() 则在工具调用前后决定它是否以及如何执行。四种扩展机制并非重复设计,而是分别作用于这三个位置,并以不同的上下文成本交换不同能力。
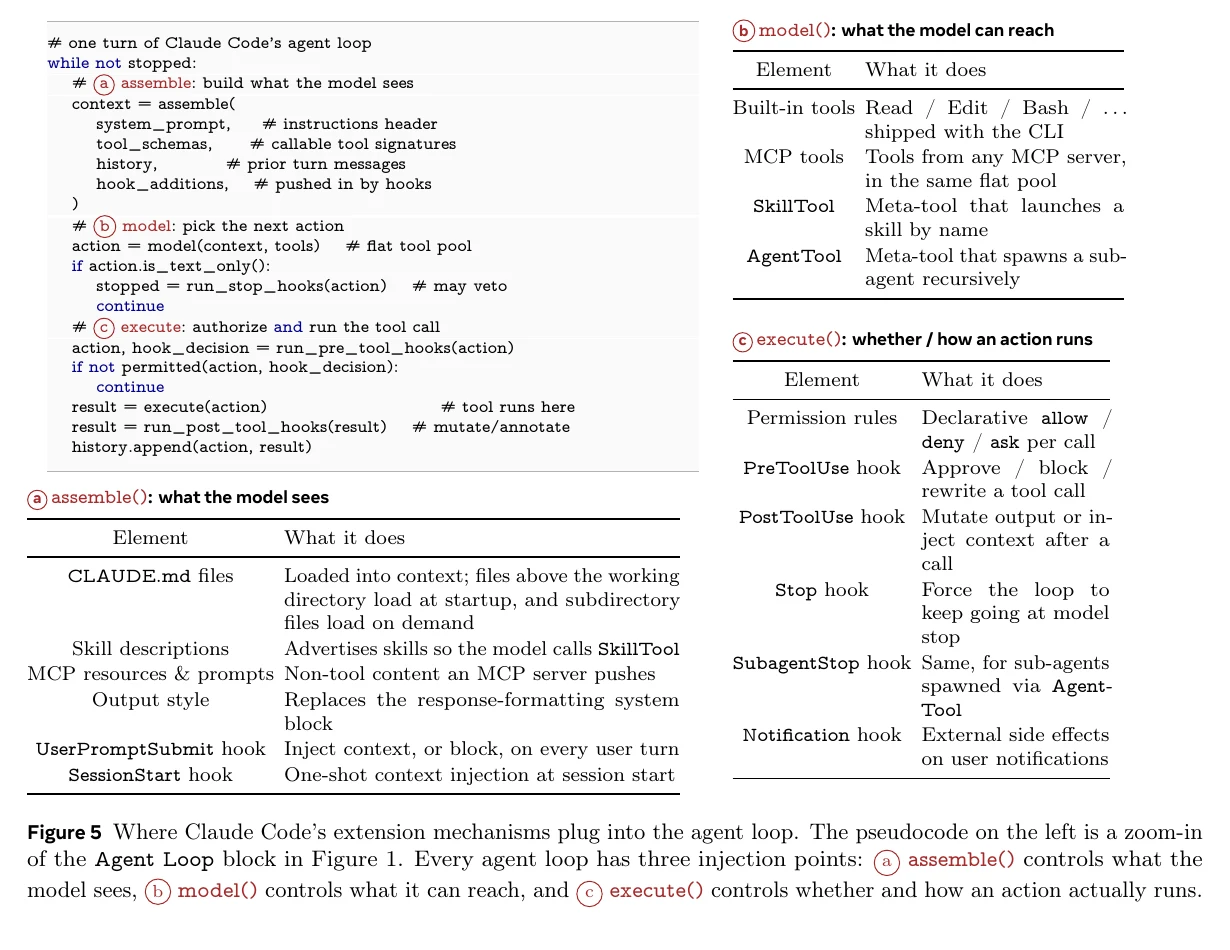
图 5:一个 Agent Loop 的具体流程,以及各类扩展机制在上下文组装、模型工具池与工具执行阶段的插入位置,截自原论文 [1]。
6.1 Four Extension Mechanisms(四类扩展机制)
- MCP servers:面向外部服务的工具集成通道。每个 MCP Server 可把工具定义加入统一工具池,并通过多种传输方式连接;模型由此获得数据库、第三方 API 等新的可调用能力,但工具 schema 会占用上下文窗口。
- Plugins:打包和分发层,而非单独的一种运行时原语。一个 Plugin 可同时携带 Command、Agent、Skill、Hook、MCP / LSP Server、输出风格和配置,并由加载器注册到各自的运行时入口。
- Skills:以
SKILL.md定义按需加载的领域工作说明。常驻上下文中通常只有简短描述,真正调用SkillTool时才注入完整指令,因此主要扩展“模型应怎样完成任务”。 - Hooks:生命周期拦截与事件驱动自动化。它们主要扩展“某个动作在何时、以何种规则、怎样被处理”,而不是向模型新增一个可调用的外部工具。
Hook 带来的扩展性
Hook 覆盖工具授权、会话、用户交互、子代理、上下文管理、工作区变更和通知等 27 类事件;其中 15 类事件具有专门的输出 schema [1]。以执行路径为例:
- 调用前:
PreToolUse可以拒绝或要求确认,并改写工具输入;它适合统一注入策略、参数校验和风险控制。 - 调用后与失败后:
PostToolUse能补充上下文;对于 MCP 工具还可改写工具结果后再放入上下文。PostToolUseFailure则可注入面向错误的后续指导。 - 权限与停止:
PermissionRequest、PermissionDenied可参与允许、拒绝或重试引导;Stop与SubagentStop可在模型准备结束时要求循环继续。 - 运行方式与来源:持久化 Hook 可执行 Shell 命令、LLM Prompt、HTTP 调用或 Agent 验证器;SDK 和内部埋点还可注册回调型 Hook。它们可来自设置、Plugin、受管策略,Skill 也能在被调用时动态注册自己的 Hook。
因此,Hook 是默认零上下文占用的横切控制面:只有主动注入额外上下文时才消耗窗口。若需求是新增“模型可以主动调用”的外部能力,应使用 MCP;若需求是对所有相关调用统一进行审计、阻断、改写、结果清洗或自动化,则 Hook 更合适 [1]。
6.2 Tool Pool Assembly(工具池装配)
assembleToolPool() 是将内置工具与 MCP 工具合并的单一事实来源;REPL.tsx 与 AgentTool.tsx 都通过它获得一致的工具集合 [1]。它以五级流水线将“系统理论上拥有的工具”收敛为“当前模型可见的工具”:
- Base tool enumeration(基础工具枚举):
getAllBaseTools()生成最多 54 个内置候选工具;其中 19 个始终提供,其他则受特性开关、环境变量、用户类型、Worktree 或 Agent swarm 等运行条件影响。 - Mode filtering(模式过滤):
getTools()根据当前模式和每个工具的isEnabled()检查可用性。例如CLAUDE_CODE_SIMPLE模式只保留 Bash、Read、Edit 等最小集合。 - Deny rule pre-filtering(拒绝规则预过滤):
filterToolsByDenyRules()在模型发起调用前,就把被全局拒绝的工具从模型视野移除。 - MCP tool integration(MCP 工具合并):对
appState.mcp.tools再应用拒绝规则,并将保留下来的 MCP 工具并入内置工具集合。 - Deduplication(去重):按工具名去重;若同名,内置工具优先于 MCP 工具。
这意味着权限不是只在工具调用时才介入:一部分拒绝策略会更早地塑造模型的 action space。装配完成后,部分延迟工具仍可先不进入提示词,直到模型经由 ToolSearch 显式查询,从而在能力覆盖与上下文成本之间继续取舍 [1]。
参考文献
[1] J. Liu, X. Zhao, X. Shang, and Z. Shen, “Dive into Claude Code: The Design Space of Today’s and Future AI Agent Systems,” arXiv:2604.14228v2 [cs.SE], 2026. [Online]. Available: https://arxiv.org/abs/2604.14228v2
[2] Anthropic, “Our Framework for Developing Safe and Trustworthy Agents,” 2025. [Online]. Available: https://www.anthropic.com/news/our-framework-for-developing-safe-and-trustworthy-agents
[3] Anthropic, “Claude’s Constitution,” 2026. [Online]. Available: https://www.anthropic.com/constitution
[4] S. Huang et al., “How AI Is Transforming Work at Anthropic,” Anthropic Research, 2025. [Online]. Available: https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
[5] M. McCain et al., “Measuring AI Agent Autonomy in Practice,” Anthropic Research, 2026. [Online]. Available: https://www.anthropic.com/research/measuring-agent-autonomy